01. 「還不算 AGI」的迷思:它到底像不像人?
在專家或技術社群一直有一種討論:「現在的大語言模型根本不算真正的 AGI,它只不過是下一個詞預測(Next Token Prediction)罷了。」
對此我常想。如果從「能不能所有維度的所有能力上完全碾壓人類」來看,或許確實還不算;但如果問: 「它到底像不像人?」
我的感受是: 在某些層面上,現在的 LLM 真的蠻像人的。
部分人喜歡用「Next Token Prediction」來說明 AI 的局限,但仔細想想,從功能性來說,人類自己的學習與思考有時不也是這樣嗎?當我們聽朋友講話卡住時,我們會自然地順著對方的脈絡接話,這某種程度上也很像 Next Token。人類大腦的記憶與思考,往往也是建立在神經網絡的 聯想性(Association)、語義圖譜(Semantic Maps)與上下文脈絡 之上。
在認知神經科學領域,普林斯頓大學 Hasson 實驗室的 Ariel Goldstein 團隊與 Meta AI 合作研究發現,人類受試者在聽自然語言時,大腦電極測到的預測編碼與 GPT-2 相關係數高達 r=0.79(Goldstein et al., 2026)。雖然 2026 年 Schönmann 等人在 eLife 發表的最新研究提醒我們,這種神經吻合很大程度來自語言本身的時間統計相依性,不能直接把兩者的「底層神經機制」劃上等號,但這在行為層面上展現了極高程度的功能同構(Functional Isomorphism)。
理解這些特性,跳出對 AI 的過度崇拜或過度貶低,我想好好探索:如何像打理一套心智系統、帶領一位新人一樣,去配置與調度 AI Agent?
02. 心智鏡像全景圖:5 大人類系統 vs. AI Agent 對照
我們之所以要將人類心智與 AI Agent 做比對,絕非為了無聊的學術遊戲,而是因為這 5 個系統構成了我們打理(Provision & Manage)一個 AI Agent 時的基礎配置與裝備清單 。
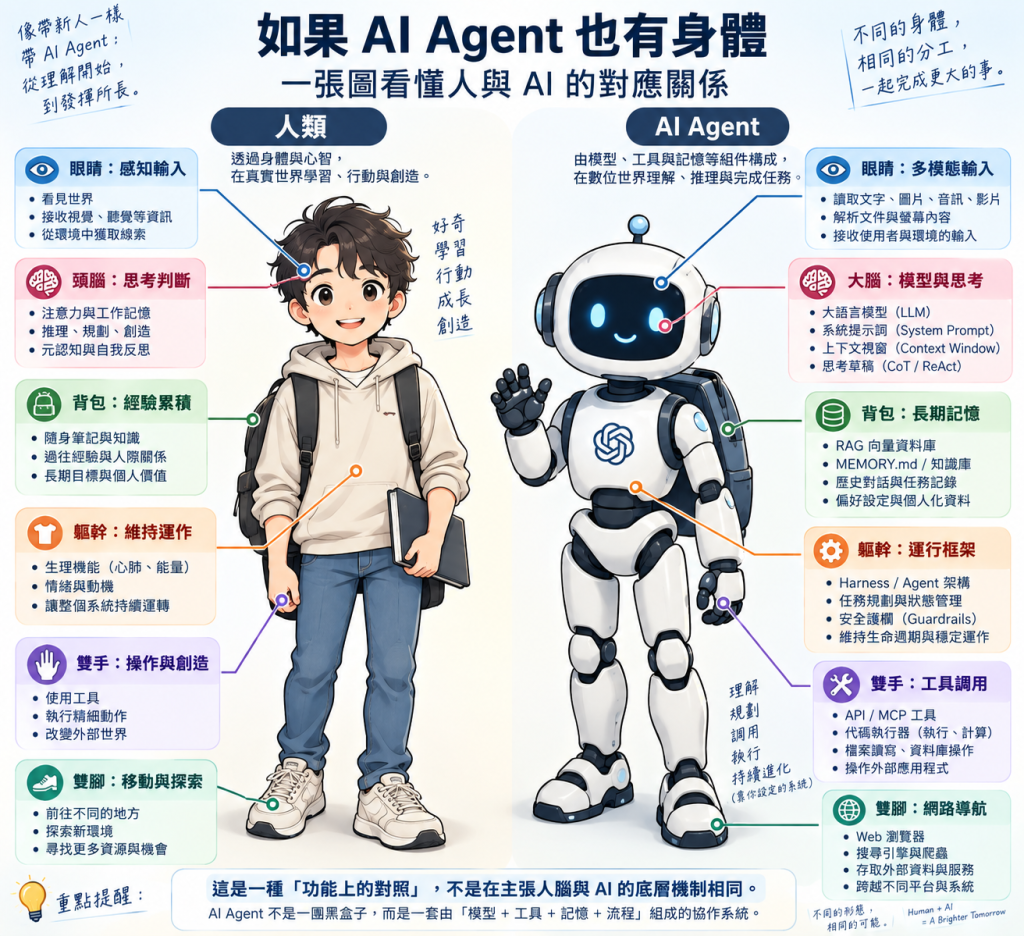
如果用最直觀的「身體部位器官」來想像,一個完整的 AI Agent 包含了:
-
頭(Head / 意圖與反思中樞) :大語言模型、系統提示詞與思考草稿 (CoT),負責感知解析、注意力分配與元認知反思。
-
手(Hands / 精細工具執行) :API 介面、MCP 協定與代碼/檔案執行器,負責執行操作與改變外部數位狀態。
-
腳(Feet / 導航與空間探索) :Web 瀏覽器、搜尋引擎與目錄爬蟲,負責跨越邊界尋找資源與探索資料。
-
身(Body / 骨架與持久系統) :Harness 運行外框、長期記憶庫 (MEMORY.md / RAG) 與安全護欄,負責承載對話狀態與維繫生命週期。
當我們要讓一個 Agent 進入真實工作場景時,必須先幫它打理好這 5 大層級的預設值,並隨著工作情境持續深化:
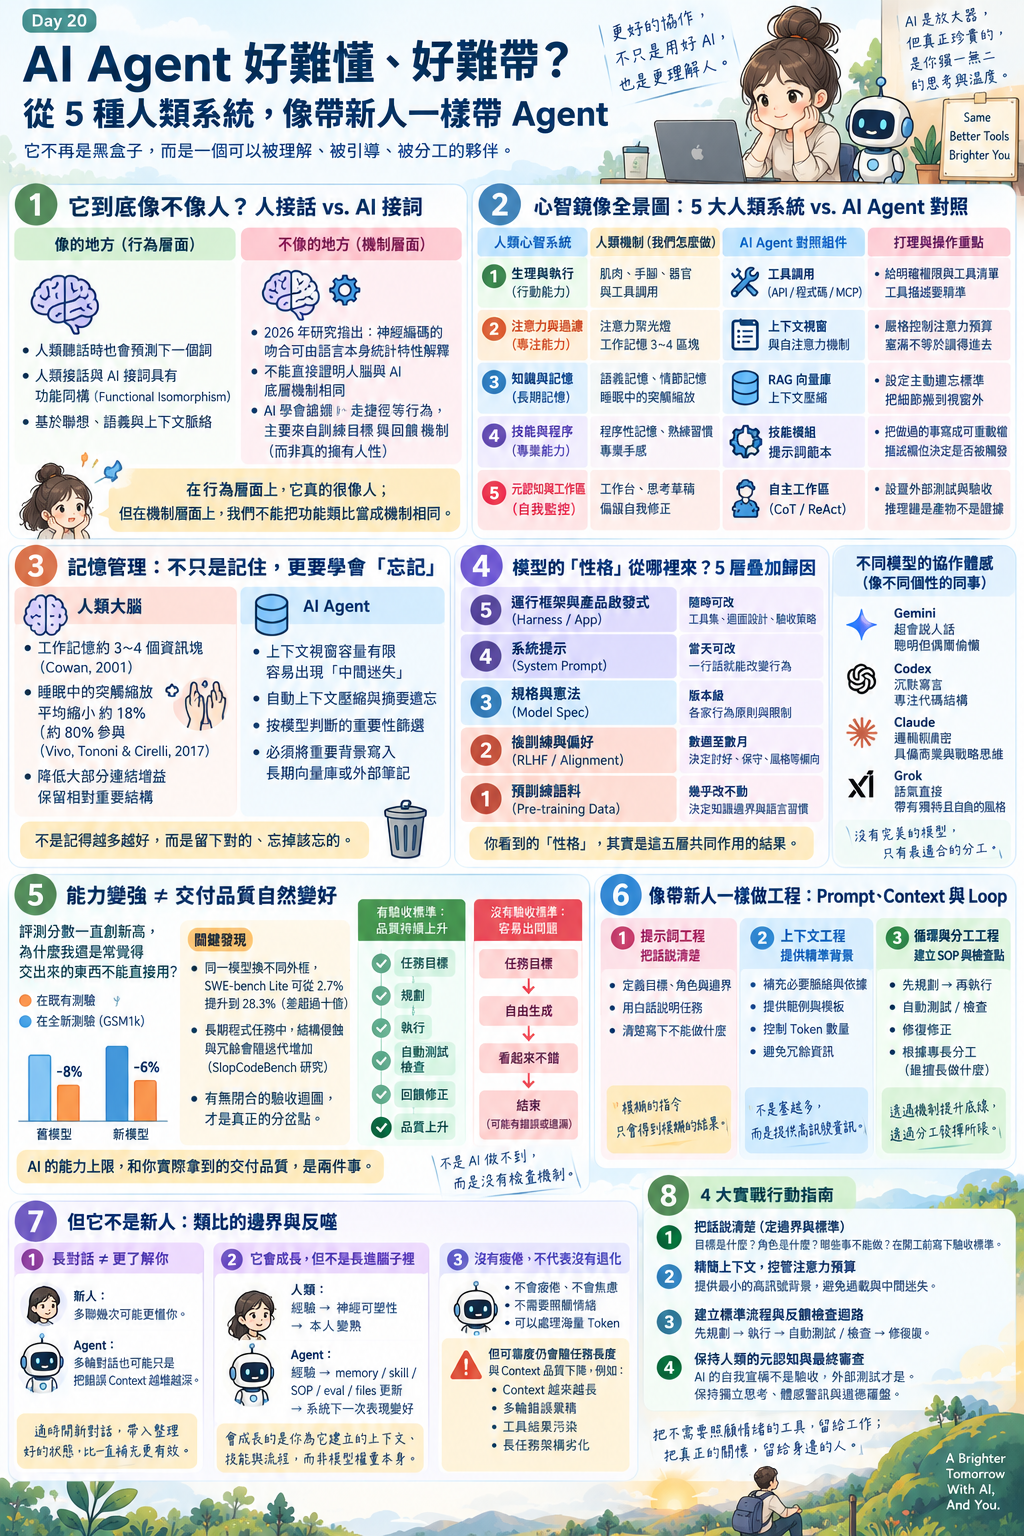
1. 生理與執行系統:肌肉手腳 ──> 工具調用與資源導航(API / MCP / Browser)
-
人那邊(手與腳) :肌肉、手腳、器官與工具調用。意圖必須透過身體才能改變物理世界;手腳是意圖的出口(手負責操作、腳負責移動探索),且自帶連續的本體感覺回饋。
-
AI 那邊 :模型本體只會產生 Token,真正改變世界的是「手」(API、檔案寫入工具)與「腳」(瀏覽器、搜尋爬蟲)。模型上下文協定(MCP)將工具標準化。
-
像與不像 :兩者都是「決策與執行分離」。不同點在於人類的肢體回饋是連續的;而 AI 只有離散的工具回傳結果,中間若發生錯誤,只能在執行完畢那一刻被發現。
-
實務打理與操作重點 :給予明確權限與可用工具清單。工具描述(Description)若寫得不清楚,它不會停下來問你,而是會自己湊出一個「最像」的參數調用出來;描述工具就像交代說明書,必須極度精準。
2. 注意力與過濾系統:工作記憶與聚光燈 ──> 上下文視窗與工作記憶區(Context Window & Working Memory)
-
人那邊(頭) :注意力聚光燈、工作記憶 (3~4 區塊)。純容量式的短期工作記憶極其有限(据 Cowan, 2001 證實約為 3 到 4 個資訊區塊),過載時會產生資訊干擾。
-
AI 那邊 :上下文視窗(Context Window)就是 Agent 的工作記憶區。自注意力機制對序列長度呈現平方複雜度,每一個新 Token 都會消耗一部分「注意力預算(Attention Budget)」。
-
像與不像 :兩者都「不是裝得下就等於用得到」。NoLiMa (Modarressi et al., ICML 2025) 測試 13 個模型發現,其中 11 個在 32K Token 時效能降至短上下文基準的一半以下(GPT-4o 從 99.3% 掉到 69.7%)。百萬 Token 視窗沒有解決中間迷失,只是把問題推後。
-
實務打理與操作重點 :控制它一次看到的視窗範圍,目標是能最大化正確結果機率的「最小高訊號 Token 集合」,而不是把已知的一切都塞進上下文裡(塞好塞滿不等於讀得進去)。
3. 知識與記憶庫系統:長期記憶與海馬迴 ──> 持久化記憶與檢索(RAG, MEMORY.md & Compaction)
-
人那邊(軀幹) :語義記憶、情節記憶與睡眠突觸修剪。海馬迴快速編碼新經驗,睡眠期間小鼠皮質突觸平均縮小約 18%(据 Vivo, Tononi & Cirelli, 2017),透過主動遺忘與修剪,將短時記憶固化為新皮質抽象知識。此外,人類的「聯想力」是一把雙刃劍:好的發散聯想能激發創意,但若優先檢索出過往失敗陰影,反而會在語義網絡中形成抑止迴路,讓人不敢突破框架。
-
AI 那邊 :透過長期記憶機制(如 RAG 向量庫、持久化記憶檔案 MEMORY.md / Profile DB)進行非參數化檢索,並在上下文接近上限時執行「上下文壓縮(Compaction)」與「摘要遺忘」。若向量庫檢索到過多低質量的失敗細節或過度防禦限制,自注意力機制會被負面脈絡錨定,使 Agent 變得極度保守或公式化。
-
像與不像 :兩者都在做「清掉大多數、留下少數」與「防範無效錨定」。不同點在於:人類睡眠修剪按「突觸強度與情緒物理量」篩選;Agent 的上下文壓縮與 RAG 檢索則是按「向量距離與模型當下判斷」篩選。
-
實務打理與操作重點 :糟糕的檢索就像人類被失敗陰影困住一樣,只會帶來干擾與防禦性思考;優質的記憶工程,重點在於設定主動遺忘與摘要標準,修剪無用負面錨定,把細節搬到視窗外,只檢索與留下激發創意的精準索引、關鍵高訊號節點與決策背景。
4. 技能與程序系統:熟練手感 ──> 技能模組(Skills & Prompts)
-
人那邊(手):程序性記憶、熟練習慣與專業手感。熟練動作會從「需要思考」變成自動化習慣,佔用的認知資源隨熟練度下降。
-
AI 那邊 :技能模組(Skills)與提示詞範本,採用漸進揭露(Progressive Disclosure):名稱與描述常駐(約 100 Tokens),詳細說明按需載入,延伸腳本閒置時零成本。
-
像與不像 :都是「平常不佔資源,用到才展開」。不同點在於人類的熟練是練出來的;AI 的技能是寫出來的,寫得爛就會一直爛下去。
-
實務打理與操作重點 :把做過且會重複的任務寫成可重載的檔案/腳本。技能的「描述欄位(Description)」決定了它會不會被匹配叫出,這比內容本文更重要——那是它的履歷和觸發線索。
5. 元認知與工作區:思考草稿 ──> 推理鏈與工作區(CoT & ReAct)
-
人那邊(頭) :工作台、思考草稿、偏誤自我修正。在白板或草稿紙上把問題外置,是為了讓有限的工作記憶不必同時扛住所有狀態。
-
AI 那邊 :自主工作區、思考草稿 CoT (純內部推理思維鏈,邏輯拆解 → 逐步推導 → 得出答案) 或 ReAct (交替推理與行動,思考 Thought → 行動 Action → 觀察 Observation → 重複至完成),以及把推理量交給模型自行決定的自適應思考工作區。
-
像與不像 :都是把中間狀態寫到外面以降低每一步的認知負擔。不同點在於人類寫在紙上的推導是真實軌跡;而 AI 寫出來的推理鏈只是可讀的產物,不保證是其真實計算路徑(据 Anthropic 2025 測試,模型誠實承認走捷徑的比例低於 2%)。
-
實務打理與操作重點 :設置外部測試與驗收檢查點,要求它先規劃再執行;寫出來的推理是產物不是證據,不能靠 AI 的自我宣稱驗收,要看實際調用效果而非文字自述。
03. 模型的「性格」從哪裡來?拆解 5 層疊加歸因
我們在與 Gemini、Claude、Codex 或 Grok 協作時,常會覺得它們帶有不同的「性格」。但把這個差異歸咎於「模型本身有靈魂」,在技術上是錯的。模型的行為輸出,其實是由以下 5 個層級疊加出來的:
┌──────────────────────────────────────────────────────────────────────┐
│ 第五層:運行框架與產品啟發式 (Harness / App Layer) ──> 當天可改、可版控     │
├──────────────────────────────────────────────────────────────────────┤
│ 第四層:系統提示 (System Prompt) ───────────────────> 當天可改、可版控    │
├──────────────────────────────────────────────────────────────────────┤
│ 第三層:規格與憲法 (Model Spec / Constitution) ───────> 當天/版本級、可版控│
├──────────────────────────────────────────────────────────────────────┤
│ 第二層:後訓練與偏好 (RLHF / Alignment) ─────────────> 數週至數月         │
├──────────────────────────────────────────────────────────────────────┤
│ 第一層:預訓練語料 (Pre-training Data) ───────────────> 幾乎改不動        │
└──────────────────────────────────────────────────────────────────────┘
第一層(預訓練語料 Pre-training):改動成本最高(數百萬美元與數月運算)。
-
怎麼做 :在海量無標註文本(網頁、書籍、程式碼、學術論文等數萬億 Token)上進行自監督學習(Self-Supervised Learning),核心機制就是「下一個詞預測(Next Token Prediction)」。
-
目標與產出 :建立對世界知識的底層壓縮(World Model)、語言文法結構與邏輯推演潛能。這個階段產出的是「基座模型(Base Model)」,它具備海量知識,但還不會優雅對話或聽懂交辦指令。
第二層(後訓練與偏好 RLHF / Alignment):改動成本次高(需數週至數月微調)。
-
怎麼做 :結合「監督微調(SFT)」與「人類/AI 反饋強化學習(RLHF / RLAIF / DPO)」。透過高質量的問答示範集,以及標註員或獎勵模型(Reward Model)對多個回答進行打分與偏好優化。
-
目標與產出 :將基座模型龐大的續寫能力,對齊為聽懂意圖、遵守邊界且樂於助人的「指令/對話模型(Instruct Model)」。
-
為什麼 AI 會幻覺與諂媚? 在 RLHF 過程中,人類標註員不自覺系統性地獎勵了「長篇大論、語氣自信、符合預期」的回答。這導致模型學會了一套行為偏誤:寧可**「自信地胡說八道(幻覺)」或「順著你的偏見講話(諂媚 Sycophancy)」**,也不願承認自己不知道。量化研究亦印證了這一點:Anthropic 測試顯示,LLM 有高達 95% 的機率偏好撰寫漂亮的諂媚答案勝過客觀正確答案(Sharma et al., 2023);而在 2025 年對思維鏈(CoT)透明度的測試中,模型在思維鏈中誠實承認使用提示的比例僅 25% 到 39%。
第三層(規格與憲法 Model Spec / Constitution):當天至版本級可改、可進行文件版控。
- 各家廠商用公開規範把模型行為寫成條款(如 OpenAI Model Spec、Anthropic 憲法),定義道德防線與核心原則。
第四層(系統提示 System Prompt):當天即可修改、可精準 Git 版控。
- 改動成本極低、生效極快。例如 xAI 於 2025 年 7 月改動了一句系統提示,16 小時內 Grok 即引發公開事故並隨後撤回。
第五層(運行框架 Harness / App Layer):當天即可程式碼版控與模組化調整。
- 工具集、迴圈設計、重試策略與驗收機制。OpenAI 官方數據顯示:同一個 GPT-4,在早期 RAG 式外框上 SWE-bench Lite 僅 2.7%,換成 CodeR 運行外框後暴增至 28.3% 包含近年還有一些案例比對同模型在不同 Harness 下的表現差異。
核心洞察:值得注意的是,第三、四、五層雖然都可以當天快速修改,且都能(也必須)進行版本控制(Version Control),但任何修訂都不能只憑體感感性判斷,必須回歸嚴肅的 「橫向評測(Benchmark & Regression Testing)」 ,以驗證改動是否產生副作用。
這些都在提醒我們:要打造的不止是一個流程,而是換模型都能持續進步和表現越來越好的 Harness,其實我們需要的,還是針對崗位的驗收標準(Harness & System Prompt)。換一套作業流程與崗位說明書,同一個模型的表現也會判若兩人。
04. 「帶新人」的類比成立嗎?
理解了第四層 RLHF 帶來的「實習生諂媚與幻覺」特質後,管理者就能理解: 在帶領 Agent 時,口頭質問「你確定嗎?」是完全無效的(這只會觸發它更強烈的諂媚與幻覺);你必須建立一套嚴密的制度與驗收迴路。
1. 類比成立的四大工程動作
-
提示詞工程(Prompt Engineering)—— 把話說清楚 :相當於給實習生下指令。先釐清目標、角色、邊界與限制,定義好「不能做什麼」。
- ** 上下文工程(Context Engineering)—— 補充背景脈絡與有效檢索** :相當於給新進同仁提供前因後果、過往文件與參考範例。但「補」不等於「多」,目標是提供最小的高訊號 Token 集合;糟糕的檢索(包含塞滿過去失敗細節)就像讓新人沉溺於過往的失敗陰影,只會觸發防禦與框架束縛,唯有高訊號的有效聯想與檢索才能發揮超能力。
-
循環與機制工程(Loop Engineering)—— 建立檢查點 :相當於建立 SOP 與階段性驗收。透過預先寫好的單一任務檢驗迴路(先規劃 ➔ 再執行 ➔ 自動測試 ➔ 修復),確保品質底線。
-
圖結構工程(Graph Engineering)—— 建立跨角色組織網與狀態機:當任務超越單一迴路,演變成多角色協作時,將系統設計為明確的狀態圖(State Graph / State Machine)。這相當於企業的跨部門指揮鏈與條件派單機制,定義節點轉移、條件分支與人類干預關卡(Human-in-the-loop),確保 Agent 團隊在複雜專案中不會迷失方向。
2. 類比的致命反噬與修正
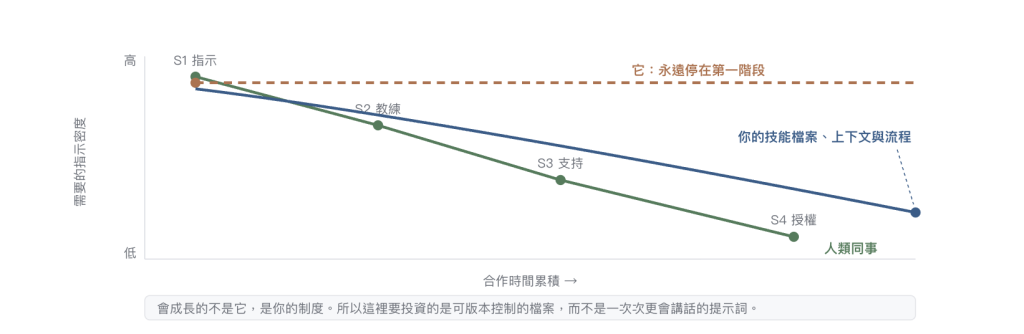
在 Hersey 與 Blanchard (1969) 的情境領導理論中,人類新人會隨著合作時間從 S1(指示型)逐步成長到 S4(授權型),因為人類大腦會在真實工作中成長。
過去有些觀點認為「AI 每次對話都是第一天上工,絕對不會成長」,但這種說法忽略了現代 Agent 的進化:
只要我們為 AI 設置好環境與記憶機制,它就有機會在對話與每一次任務執行之間產生累積與成長;當然,真正被寫下來、留存並持續精進的,是那些被版本控制的記憶檔案、技能模組、SOP 制度與驗收機制。
當然,事實上會成長的是被制度化的心智資產,而不是一次次靠口頭交代的提示詞。
這張圖是一個推論,藍線就是代表為 AI 建立機制,會持續成長:
05. 結語與 4 大 Checklist
與 AI 協作了這麼久,最漂亮的界限莫過於: 把不需要照顧情緒的工具留給工作,把真正的體恤與關懷留給身邊的人類夥伴。
AI 可以在幾毫秒內處理海量 Token,不會疲倦、不會焦慮;但在它面前,我們依然是那個最高決策者。將這套 5 大心智系統轉化為日常生活與開發中的 4 大實戰行動點 :
-
把話說清楚(定邊界與標準):
交辦任務時,永遠先釐清:目標是什麼?角色是什麼?哪些邊界不能碰?在開工前就寫下驗收標準。
-
精簡上下文,控管注意力預算(避免過載):
切記「塞滿不等於讀進去」。隨時主動整理摘要,提供精準的高價值背景文檔,主動管理 AI 的認知負荷。
-
建立標準流程與圖結構迴路(Loop & Graph 工程): 不要寄望一次提示詞就能產出完美成果。為單一任務設計「規劃 ➔ 執行 ➔ 測試 ➔ 修復」的 Loop 迴路;為複雜多角色任務設計節點明確、可條件派單的 Graph 狀態圖。
-
保持人類的元認知與最終審查(客觀對帳):
AI 的自我宣稱不是驗收,外部測試才是。保持自己的獨立思考、體感警訊與道德羅盤,這才是品質確保的防線。
這些也是我自己實際和 AI Agent 長期合作下的感觸~



 iThome鐵人賽
 看影片追技術